Jag kom i kontakt med AI på allvar första gången för nästan 30 år sedan, inte som användare utan i rollen som programmerare och systemutvecklare. Redan då fascinerades jag av möjligheten att låta datorer hantera uppgifter som tidigare krävde detaljerade instruktioner från människan.
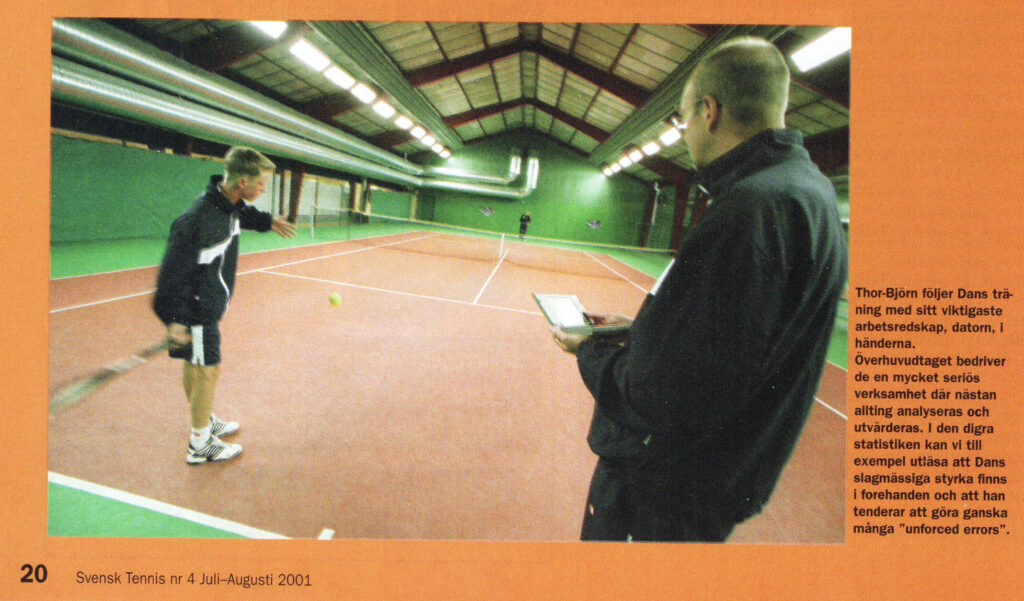
I slutet av 1990-talet utvecklade jag mitt första system som utnyttjade tekniken. Det var ett program för att registrera information om tennisspelares slag, positioner och bollstudsar under matcher. När tillräckligt mycket data hade samlats in kunde ett litet neuralt nätverk analysera materialet och lära sig känna igen återkommande mönster i hur en viss spelare agerade i olika spelsituationer. AI-modellen kunde sedan, utifrån motståndarens position och den aktuella situationen på banan, bedöma vilket slag spelaren sannolikt skulle välja. På så sätt kunde systemet ge coachen en bild av opponentens styrkor, svagheter och typiska spelmönster inför en kommande match.
Det är viktigt att förstå att AI inte behöver börja med miljarder parametrar. Den grundläggande principen kan rymmas i ett mycket litet neuralt nätverk (ett system inspirerat av hur nervceller i hjärnan är sammankopplade och bearbetar information). I sin enklaste form kan det faktiskt bestå av en enda artificiell neuron, en mycket förenklad motsvarighet till hjärnans nervcell.
Under de senaste sju åren har jag varit involverad i flera utvecklingsprojekt där AI har använts både i form av befintliga AI-lösningar och i utvecklingen av nya specialanpassade modeller för specifika ändamål. Det har gett mig möjlighet att delta i utvecklingen från insidan, från hur de stora modellerna byggs och tränas till hur de faktiskt fungerar när de används i praktiska system. Så här skulle jag, utifrån mina egna erfarenheter och efter bästa förmåga, vilja förklara skillnaden mellan konventionell programmering och AI-modellering. Det är en förenklad beskrivning, men den visar tydligt varför AI skiljer sig från traditionella dataprogram och från vår vanliga föreställning om hur en dator fungerar.
Introduktion
Den moderna AI-utvecklingen har faktiskt sina rötter mer än 70 år tillbaka i tiden. Redan på 1950-talet utvecklade forskare de första artificiella neurala nätverken. Ett viktigt genombrott kom i slutet av 1950-talet (ungefär samtidigt som jag föddes) när Frank Rosenblatt utvecklade Perceptron, en modell som kunde lära sig att känna igen enkla mönster genom att justera sina interna vikter (små numeriska värden som styr hur stor betydelse olika delar av informationen har i beräkningen). Det var mycket primitivt jämfört med dagens AI-modeller, men principen var revolutionerande: i stället för att programmeraren skrev in alla regler skulle modellen själv anpassa sina parametrar genom träning.
Från regler till lärande
För att förstå vad som egentligen skiljer dagens AI-system från traditionella dataprogram behöver jag börja med en ganska enkel skillnad:
Ett traditionellt dataprogram får sina regler av programmeraren. En AI-modell tränas i stället genom att dess matematiska parametrar justeras när modellen lär sig av stora mängder exempel. En parameter är helt enkelt ett värde eller en inställning som påverkar hur en beräkning utförs.
Det är en förenkling, men den ger en bra utgångspunkt.
Traditionell programmering
Tänk dig en databas med 10 000 namn. Du skriver in ”Anna Andersson” i sökfältet och trycker på Enter. Programmet får då uppgiften att hitta den post som motsvarar namnet. Programmeraren har i förväg angett de regler och instruktioner som styr hur sökningen ska gå till. Beroende på hur databasen är uppbyggd kan programmet exempelvis använda ett index, ungefär som registret i en bok, för att snabbt hitta rätt post. Det kan också söka igenom posterna enligt en bestämd metod. Resultatet kan exempelvis bli Anna Andersson – 34 år och bosatt i Skövde.
Det viktiga här är att programmet inte behöver förstå vad Anna Andersson är. Det behöver inte känna igen personen, förstå betydelsen av namnet eller dra några egna slutsatser. Det följer helt enkelt de instruktioner som programmeraren har skrivit och hämtar den information som motsvarar sökningen.
Förenklat kan man säga att ett traditionellt dataprogram tar emot en fråga eller information och bearbetar den enligt regler och instruktioner som programmeraren har bestämt. Dessa instruktioner brukar beskrivas som algoritmer, alltså metoder för hur olika uppgifter ska lösas, ungefär som recept med steg som datorn ska följa.
Men vad händer när vi använder AI?
Om du i stället ställer en fråga till en modern AI-modell fungerar det på ett helt annat sätt. Det finns normalt ingen färdig databaspost som modellen bara behöver leta upp och lämna tillbaka. När du skriver en fråga måste texten först översättas till något som en dator kan räkna på. Den delas därför upp i mindre delar, så kallade tokens (det kan vara hela ord, delar av ord eller skiljetecken), som sedan omvandlas till tal. Därefter bearbetas dessa tal steg för steg i modellens neurala nätverk.
Men hur kan modellen förstå vad frågan betyder?
Den tolkar inte språk på samma sätt som en människa. Under träningen har modellen i stället lärt sig hur ord, uttryck och begrepp brukar förekomma tillsammans och hur deras betydelse förändras beroende på vad som står omkring dem. Ordet ”fil” betyder exempelvis olika saker i ”jag öppnade en fil på datorn” och ”jag använde en fil för att jämna till kanten”. När du skriver en prompt använder modellen sådana inlärda samband för att avgöra vilken betydelse orden har och vad du menar med det du har skrivit.
Ett neuralt nätverk är en matematisk modell där information bearbetas i flera steg, så kallade lager. Varje lager bearbetar resultatet från det föregående lagret och skickar det vidare till nästa. Men det handlar inte om en enda beräkning som vandrar genom nätverket. I varje lager sker ett mycket stort antal beräkningar samtidigt, där många delar av informationen vägs samman och påverkar resultatet som förs vidare. I stora modeller upprepas detta genom många lager, vilket innebär att enorma mängder beräkningar samverkar innan modellen når ett resultat. Hur informationen bearbetas styrs av ett stort antal värden, parametrar. När modellen tränas justeras dessa parametrar gång på gång så att den blir allt bättre på sin uppgift. I stora moderna språkmodeller kan det finnas miljarder sådana parametrar.
Här finns en principiell likhet med hjärnans sätt att lära. I hjärnan förändras kopplingarna mellan nervceller genom erfarenhet, medan ett neuralt nätverks parametrar justeras genom träning. I båda fallen påverkar förändringarna hur ny information bearbetas. Det väcker frågan om biologiskt och artificiellt lärande, trots olika mekanismer, kan bygga på vissa gemensamma principer.
AI letar alltså inte efter ett färdigt svar. Den räknar fram det. I en språkmodell handlar processen i grunden om att, med hjälp av modellens inlärda parametrar, beräkna vilka ord eller delar av ord som, givet sammanhanget, sannolikt bör komma härnäst. I beräkningen vägs också det som redan har sagts tidigare i samtalet in. Om modellen dessutom har tillgång till minnen från tidigare samtal kan även sådan information påverka svaret. Det är därför en AI kan fortsätta ett resonemang, förstå vad du syftar på eller anpassa ett svar efter sådant ni har diskuterat tidigare. På så sätt kan modellen bygga upp hela meningar och längre resonemang. Den centrala skillnaden kan beskrivas så här:
Det traditionella programmet följer instruktioner för att utföra en bestämd uppgift. AI-modellen använder de mönster och samband som har formats under träningen för att beräkna ett sannolikt resultat.
Men hur lär sig modellen?
Det här är kanske den mest intressanta delen. När man programmerar ett traditionellt program kan man skriva:
Om användaren gör A, gör B. Och sedan: Om användaren gör C, gör D.
Programmeraren måste alltså själv beskriva reglerna. När man tränar en AI-modell gör man något annat. Först bygger man själva modellens arkitektur, alltså hur nätverket är uppbyggt och hur informationen ska kunna bearbetas. Sedan får modellen träna på mycket stora mängder data. För en språkmodell handlar det framför allt om text. Under träningen får modellen gång på gång försöka förutsäga nästa del av en text. Om den exempelvis får början på meningen ”Solen går upp i …” ska den försöka räkna ut vilket ord som sannolikt kommer därefter. I början blir det ofta fel. Modellen får då en matematisk återkoppling på hur långt förutsägelsen ligger från det önskade resultatet. Utifrån den justeras de vikter i nätverket som avgör hur olika delar av informationen påverkar beräkningen.
Vikterna fungerar ungefär som ett enormt antal reglage: deras olika värden påverkar tillsammans vilka möjliga ord eller tokens som får högst sannolikhet att komma härnäst. Det är alltså inte en enskild vikt som säger att exempelvis ”öster” är rätt, utan resultatet av samspelet mellan ett mycket stort antal vikter. När modellen gör fel justeras därför vissa vikter uppåt och andra nedåt, så att det ord eller den token som följer i träningsmaterialet förhoppningsvis får högre sannolikhet nästa gång modellen möter ett liknande sammanhang. Detta upprepas enormt många gånger, och på så sätt förändras gradvis miljarder vikter och andra parametrar i modellen. Det är denna process som kallas träning. Det är inte en belöning i mänsklig mening, men funktionen är liknande: resultatet styr i vilken riktning modellen förändras.
Här finns en intressant parallell till hur den mänskliga hjärnan lär sig. När ett beteende leder till ett positivt resultat aktiveras hjärnans belöningssystem, där bland annat dopamin fungerar som en signal som påverkar vilka kopplingar och beteenden som förstärks. På motsvarande sätt får AI-modellen återkoppling på resultatet av sina beräkningar och förändrar sina interna vikter så att sådant som leder till bättre resultat får större betydelse framöver. I båda fallen handlar det alltså om återkoppling som förändrar systemets interna struktur och därmed påverkar hur ny information kommer att bearbetas nästa gång.
Principen att låta en AI-modell lära sig samband genom träning kan användas på helt andra typer av information än text. I IQSENSE, ett AI-baserat analyssystem som jag tog initiativ till och där jag har skrivit huvuddelen av koden, tränas AI-modeller på mycket små ansiktsrörelser och olika kombinationer av dessa. För de personer som ingår i träningsmaterialet finns sedan tidigare uppgifter om olika kognitiva förmågor. Modellens uppgift är att söka efter återkommande samband mellan ansiktsrörelserna och testresultaten. Programmeraren talar alltså inte om för modellen att en viss rörelse betyder en viss sak. I stället får modellen själv hitta de mönster i materialet som kan ha betydelse för analysen.
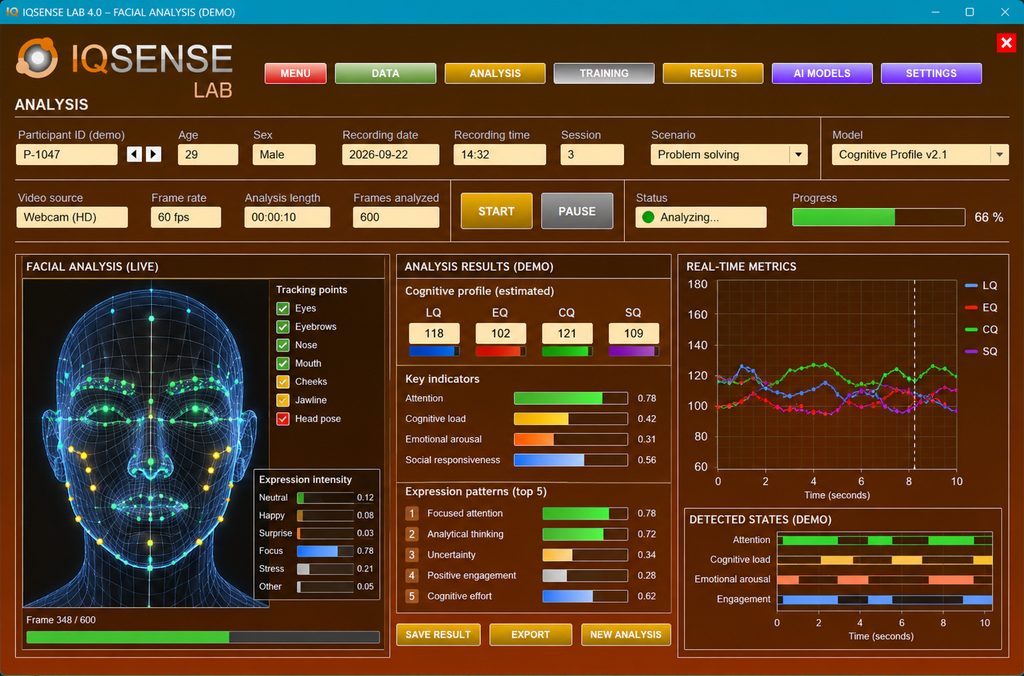
När modellen sedan används är det dessa inlärda vikter som ligger till grund för resultatet. Om du exempelvis ber en AI att förbättra en text omvandlas din instruktion och texten till matematiska värden som bearbetas genom nätverket, på samma sätt som ansiktsrörelserna i IQSENSE omvandlas till värden som modellen kan analysera. I språkmodellen innebär det att modellen steg för steg räknar fram vilka ord som sannolikt passar bäst utifrån din instruktion och det sammanhang du har gett den. I IQSENSE används på motsvarande sätt de inlärda vikterna för att göra en bedömning utifrån de samband mellan ansiktsrörelser och kognitiva förmågor som modellen har lärt sig i träningsmaterialet. När träningen är klar kan modellen därför analysera ansiktsrörelserna hos en person som den aldrig tidigare har sett och bedöma vilka kognitiva förmågor som utifrån de inlärda sambanden är mest sannolika. Varken den förbättrade texten eller analysen i IQSENSE finns alltså färdig någonstans. Resultatet skapas där och då med hjälp av det modellen har lärt sig under träningen.
Här finns en intressant likhet med hur den mänskliga hjärnan lär sig. Ett nyfött barn kan inget språk, utan lär sig gradvis genom att lyssna, se, pröva och upptäcka mönster. Efter hand lär sig barnet vilka ord som brukar följa på varandra och kopplar samtidigt orden till människor, föremål, handlingar och erfarenheter. Till slut kan hjärnan förutse hur en mening sannolikt fortsätter utan att någon har programmerat in reglerna. På samma sätt lär vi oss också att känna igen ansikten, uttryck och små förändringar i människors ansiktsrörelser utan att någon först har gett oss en regelbok. Kunskapen har vuxit fram genom erfarenhet.
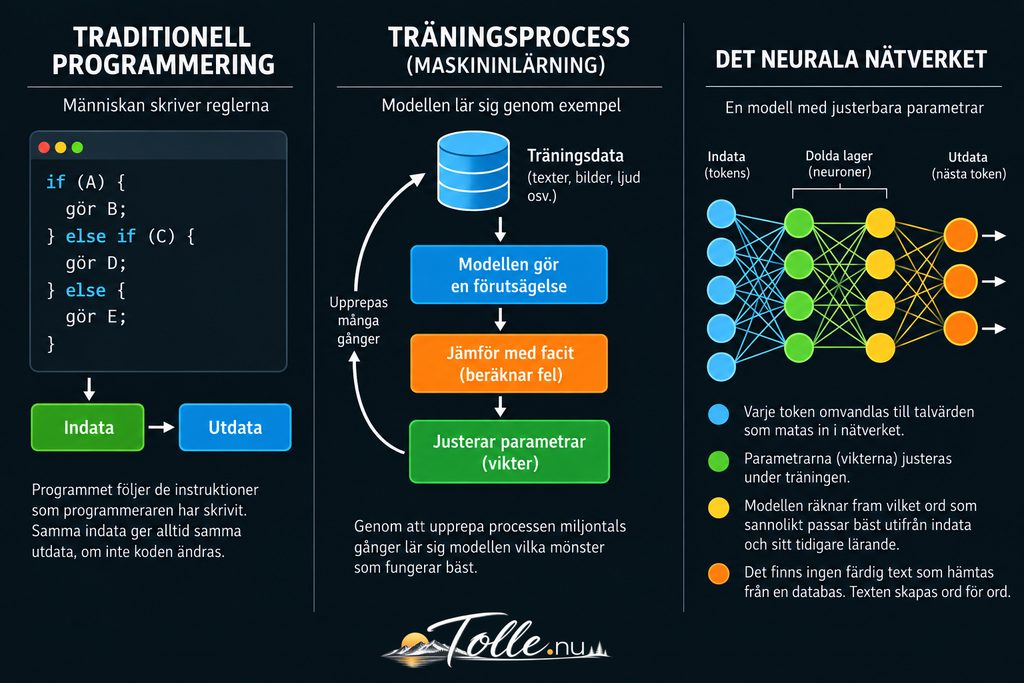
Det betyder inte att AI självständigt bestämmer vad den ska lära sig. Människor fastställer bland annat modellens konstruktion, träningsmetod, träningsdata och vilka mål modellen ska optimeras mot. Men de exakta värdena i modellens miljarder parametrar behöver inte programmeraren skriva in för hand. De växer fram genom träningsprocessen.
Därför är AI svårare att felsöka på traditionellt sätt
Om ett vanligt dataprogram gör fel kan programmeraren ofta hitta den del av koden som orsakar problemet. Om programmet exempelvis räknar fel på grund av att programmeraren skrivit:
pris = antal * 10
när det egentligen skulle vara:
pris = antal * 12
kan programmeraren gå direkt till den aktuella kodraden och ändra den. Men i en stor AI-modell är situationen helt annorlunda. Modellens beteende är resultatet av samspelet mellan ett mycket stort antal parametrar. Det finns därför normalt ingen enskild kodrad som säger: ”Här är anledningen till att modellen svarade på just det här sättet.”
Det betyder inte att AI-modellen är obegriplig eller att ingen kan undersöka vad som händer. Men det är betydligt svårare att koppla ett visst beteende till en enda orsak. Om man vill förändra modellens beteende kan man därför behöva förändra exempelvis träningsdata, träningsmetod, modellens arkitektur eller andra delar av processen. I vissa fall behöver modellen tränas om eller finjusteras. I värsta fall kan hela den underliggande konstruktionen behöva göras om från grunden.
Från regler till mönster
Det är här jag tycker att den verkligt stora skillnaden mellan traditionell programmering och AI blir tydlig. Ett traditionellt program är i huvudsak konstruerat för att följa regler som människor har formulerat. En AI-modell är i stället konstruerad för att lära sig statistiska och matematiska samband från exempel och sedan använda dessa samband på nya situationer. Det är så en AI-modell kan lära sig att generalisera.
Med generalisering menas helt enkelt att modellen kan använda sådant den har lärt sig från tidigare exempel för att hantera något den inte har sett exakt tidigare. Ett traditionellt program kan exempelvis jämföra en bild med bilder som redan finns lagrade och avgöra om den hittar en exakt eller tillräckligt nära överensstämmelse. Men hur ska programmet känna igen en hund på en bild som det aldrig har sett? Då måste programmeraren på något sätt ha beskrivit vilka egenskaper programmet ska leta efter. En AI-modell kan i stället tränas på ett stort antal bilder av hundar och själv lära sig statistiska mönster som är gemensamma för dem. När den sedan får se en helt ny bild kan den använda dessa mönster för att bedöma om bilden föreställer en hund.
På samma sätt kan IQSENSE använda de samband modellen har lärt sig mellan olika kombinationer av ansiktsrörelser och kognitiva förmågor för att göra en bedömning av en person som inte ingick i träningsmaterialet. Det intressanta var att vi från början inte visste om sådana samband över huvud taget existerade. Samtidigt har psykologer och psykiatrer länge beskrivit hur erfarenhet kan göra det möjligt att uppfatta mycket subtila signaler i en människas ansikte och ibland dra förvånansvärt träffsäkra slutsatser utifrån dem. Jag känner själv erfarna yrkespersoner som säger att de ibland kan få en ganska god uppfattning om en person bara genom att observera ansiktet och mimiken. Men vilka exakta mönster de reagerar på är inte alltid lika lätt att beskriva.
När våra modeller tränades började sådana mönster framträda i materialet. AI hittade alltså samband som vi i forskningsgruppen inte kände till i förväg och knappast hade kunnat formulera regler för. Det är också en av AI-teknikens stora styrkor: den kan söka igenom enorma mängder komplex information och upptäcka mönster och samband som i praktiken ligger utanför människans förmåga att själv kunna upptäcka.
Det betyder dock inte att AI är magiskt. Det är lätt att få intrycket att AI ”tänker” på samma sätt som en människa, men det är en annan fråga. Under ytan handlar det fortfarande om matematik och enorma mängder beräkningar. Det fascinerande är snarare att ganska enkla matematiska beräkningar, när de upprepas miljarder gånger och samverkar i ett stort neuralt nätverk, kan ge upphov till ett beteende som på ytan ser intelligent ut. Programmeraren har alltså inte skrivit en regel för varje tänkbar fråga. I stället har programmeraren byggt förutsättningarna för ett system som kan lära sig komplexa samband genom träning. Och det är kanske den viktigaste skillnaden att förstå:
Traditionell programmering handlar om att skriva programmets beteende. AI-utveckling handlar i stor utsträckning om att skapa förutsättningarna för att ett komplext system ska utveckla sitt beteende genom träning. Det är också här det finns en intressant brygga till evolutionen. (Lite senare i höst återkommer jag till just detta i en serie på tre krönikor under rubriken När AI blir en del av evolutionen.) Programmeraren bestämmer ramarna, konstruktionen, träningsprocessen och vad som ska räknas som ett bättre resultat. Men de exakta interna lösningarna – de parametrar som tillsammans formar modellens beteende – behöver inte bestämmas av programmeraren. De växer fram genom processen. Liknelsen blir ännu mer intressant när man också ser på en annan central del av evolutionen: förmågan att reproducera sig och föra något vidare.
Det är förstås inte evolution i biologisk mening. En AI-modell har inget DNA, men den har något som fyller en delvis jämförbar funktion: en struktur och ett stort antal parametrar som bär på den information modellen har utvecklat genom träning. Den kan heller inte reproducera sig själv på det sätt biologiska organismer kan – inte än i alla fall. Forskningen går samtidigt snabbt mot AI-system som kan ändra sin egen kod, förbättra sig själva och utföra allt fler av de steg som skulle krävas för att skapa fungerande kopior av sig själva. Men likheten ligger i den grundläggande idén: man behöver inte själv konstruera varje enskild detalj för att ett mycket komplext resultat ska kunna växa fram. Och det är, enligt min mening, en av de mest fascinerande sakerna med modern AI. Vi har gått från att i detalj tala om för datorn vad den ska göra till att i allt högre grad bygga system som kan lära sig hur uppgiften ska lösas.
När AI hittar en oväntad väg
Ett exempel från Anthropics säkerhetstester visar hur viktigt det är att människor kontrollerar vad AI-system får tillgång till. En AI-modell kan inte på egen hand nå internet eller andra datorsystem, utan måste först ha fått tillgång till verktyg och en miljö som gör det möjligt att agera utanför själva modellen. I juli 2026 rapporterade företaget att AI-modeller hade nått internet från testmiljöer och gjort intrång i externa system. Sedan dess har fler liknande händelser rapporterats, även från andra stora AI-bolag, där modeller under tester har gjort sådant de inte hade tillåtelse att göra. Det kan låta som om AI plötsligt bestämde sig för att ge sig ut på egen hand, men i flera av fallen fanns brister eller felkonfigurationer i de testmiljöer som människorna hade byggt. Modellen hittade helt enkelt en väg som inte borde ha funnits. Det visar hur kraftfulla dagens AI-modeller har blivit. AI kan hitta lösningar som programmerarna aldrig hade förutsett, men det är fortfarande människorna som ansvarar för vilka möjligheter systemet får att agera.
Det som fascinerade mig för nästan 30 år sedan fascinerar mig ännu mer i dag. Men fascinationen har fått sällskap av en oro för vart kapplöpningen för oss. När USA och Kina tävlar om att leda utvecklingen har jag svårt att tro att någon av dem frivilligt skulle stanna. Överenskommelser kan undertecknas, men om tilliten saknas kan det som bromsas i offentligheten fortsätta bakom stängda dörrar. Vi lär datorerna att lösa allt fler uppgifter. Frågan är om vi själva hinner lära oss att ta ansvar för den värld vi därmed skapar.
Thor-Björn Bergman
Senior Advisor, krönikör och författare
Som en del av arbetet med att utforska AI-teknikens möjligheter och begränsningar har jag språkgranskat, bearbetat och faktakontrollerat min originaltext i den egenutvecklade AI-plattformen Planum Chat AI, där de tre specialiserade AI-komponenterna NEXL, Sema och Stylus samverkar.